模型
根据需要的变化选择模型。快速免费模型适合验证方向;积分模型可能在风格控制、还原度、速度或输出选项上提供不同能力。
Img2Img 工作流指南
从一张图片开始,明确哪些内容必须保持可识别,再描述具体要改变什么。这份实用的 Img2Img 指南把可用生成器、提示词、设置、案例与问题修复方法放在一起,让你下一次生成就能直接使用。
可直接使用的生成器
上传你拥有或获准使用的原图,说明哪些内容要保留、哪些要改变,再选择当前可用的模型和生成设置。工具与指南放在同一页,每学到一个方法都可以立即实践。
定义与实际限制
Img2Img 是图生图生成:现有图片提供视觉起点,提示词和模型设置决定需要改变的内容。
它适合重塑人像风格、完善草图、将产品放入新场景,以及在保留关键视觉特征的同时探索不同方案。
可重复执行的方法
当你把原图当作视觉证据,而不只是装饰时,Img2Img 最有价值。先给模型清楚的视觉锚点,再指定一个明确变化,最后检查结果是否保留了真正重要的细节。
选择清楚的照片、产品图、草图、插画或以前的 AI 结果。主体明确、构图有意图的图片,会给模型更可靠的起点。
明确主体、身份、姿势、轮廓、镜头角度、空间布局、Logo 位置,或其他必须保持可识别的视觉锚点。
指定新的场景、材质、灯光、配色、媒介或氛围。一个连贯的方向,比一串互不相关的想法更容易判断效果。
把结果与原图并排检查。关注身份、人体结构、文字、Logo、比例和产品细节,再只修改造成偏差的那条指令。
控制生成结果
设置应该服务于当前任务。需要保持构图时先沿用原图比例;优化提示词阶段先生成一张;方向稳定后,再增加质量或生成张数。
根据需要的变化选择模型。快速免费模型适合验证方向;积分模型可能在风格控制、还原度、速度或输出选项上提供不同能力。
需要保留取景时,优先匹配原图比例。只有新裁切本身就是需求时才改变比例,同时预期模型会重新解释画面边缘空间。
修正提示词时一次生成一张。指令稳定后,多张输出才更有价值,因为你可以在不改变需求的前提下比较不同结果。
先用低成本预览确认构图和方向。等原图、提示词、模型和比例都能得到正确结果后,再提高质量处理最终细节。
提示词结构
有效的 Img2Img 提示词会把视觉锚点和目标变化分开说明。这样结果更容易检查;当模型改得太多或太少时,你也知道应该修改哪一句。
说明必须保持可识别的主体、身份、姿势、轮廓、产品形状、房间布局或镜头角度。
用具体视觉语言描述新的环境、灯光、材质、服装、配色、媒介或画面处理。
增加一个连贯方向,例如杂志摄影、手工黏土、漫画墨线或温暖的建筑渲染。
写出需要复核的约束:保持面部身份、保留标签位置、固定窗户位置,或不要改变镜头角度。
问题排查
结果不理想时,不要把整段提示词全部重写。先判断偏差来自视觉锚点、目标变化、构图还是细节,再只调整对应部分。
在提示词开头再次强调视觉锚点。准确描述身份、姿势、轮廓或产品特征;如果所选模型提供变化强度,再适当降低。
把“更好”“更有创意”等抽象词,替换为可见的灯光、材质、场景、配色或媒介选择。要求一个更明确的方向,而不是多个轻微变化。
重新说明镜头角度、裁切、主体位置和空间布局。除非新构图就是目标,否则使用接近原图的宽高比。
把这些视为必须检查的项目,而不是模型一定能保证的结果。明确点名错误细节后重新生成或修订,并在发布前用原尺寸检查品牌资产和文字。
判断可见变化
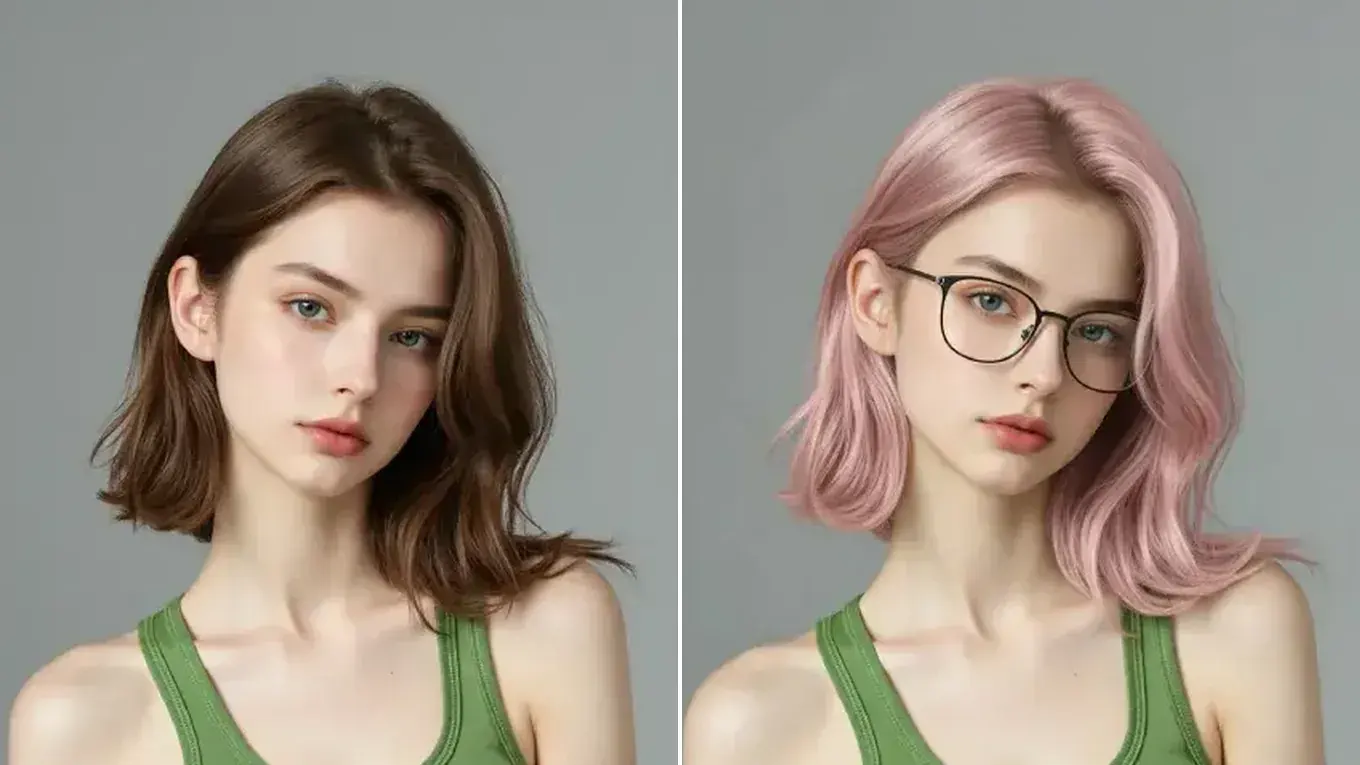
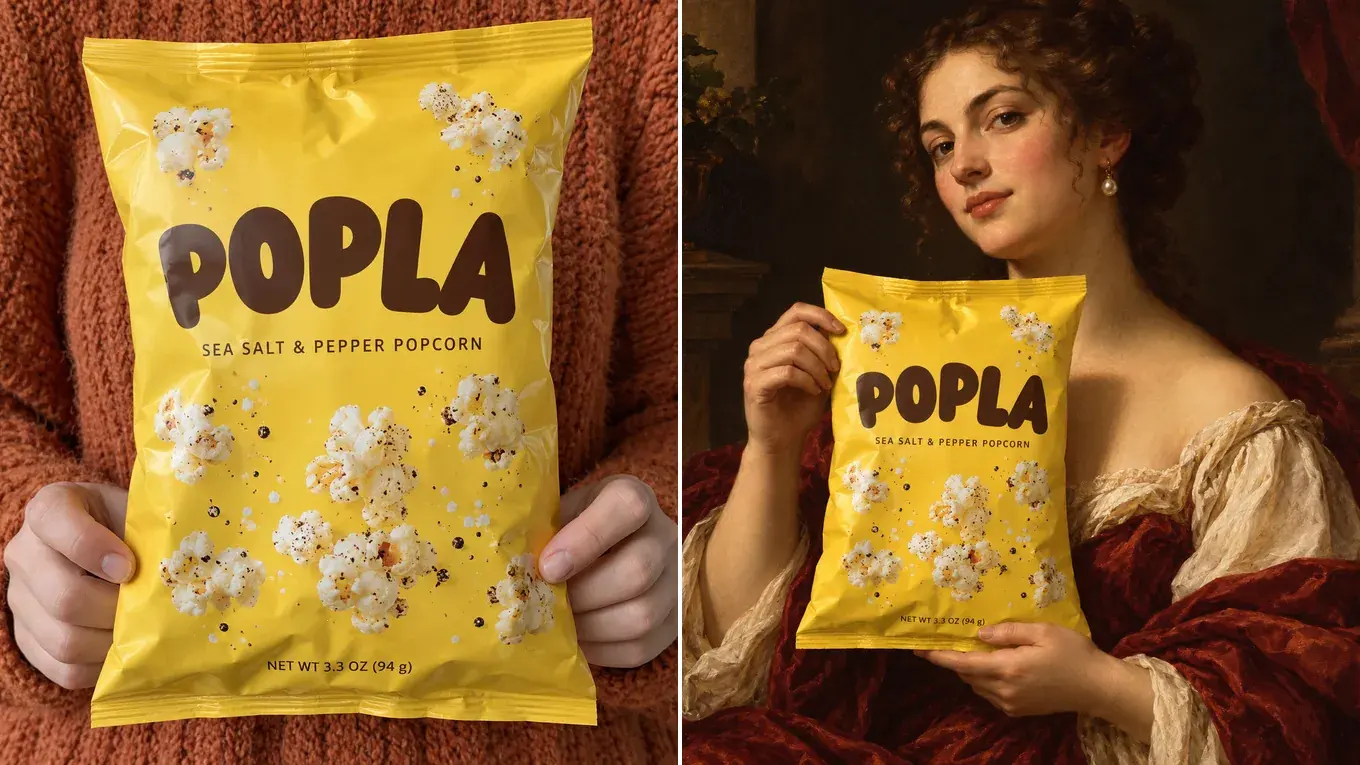
好的案例会同时呈现保留与改变。原图仍然能够解释结果来源,而新图也会在场景、媒介、材质或氛围上产生清晰且有意义的差异。
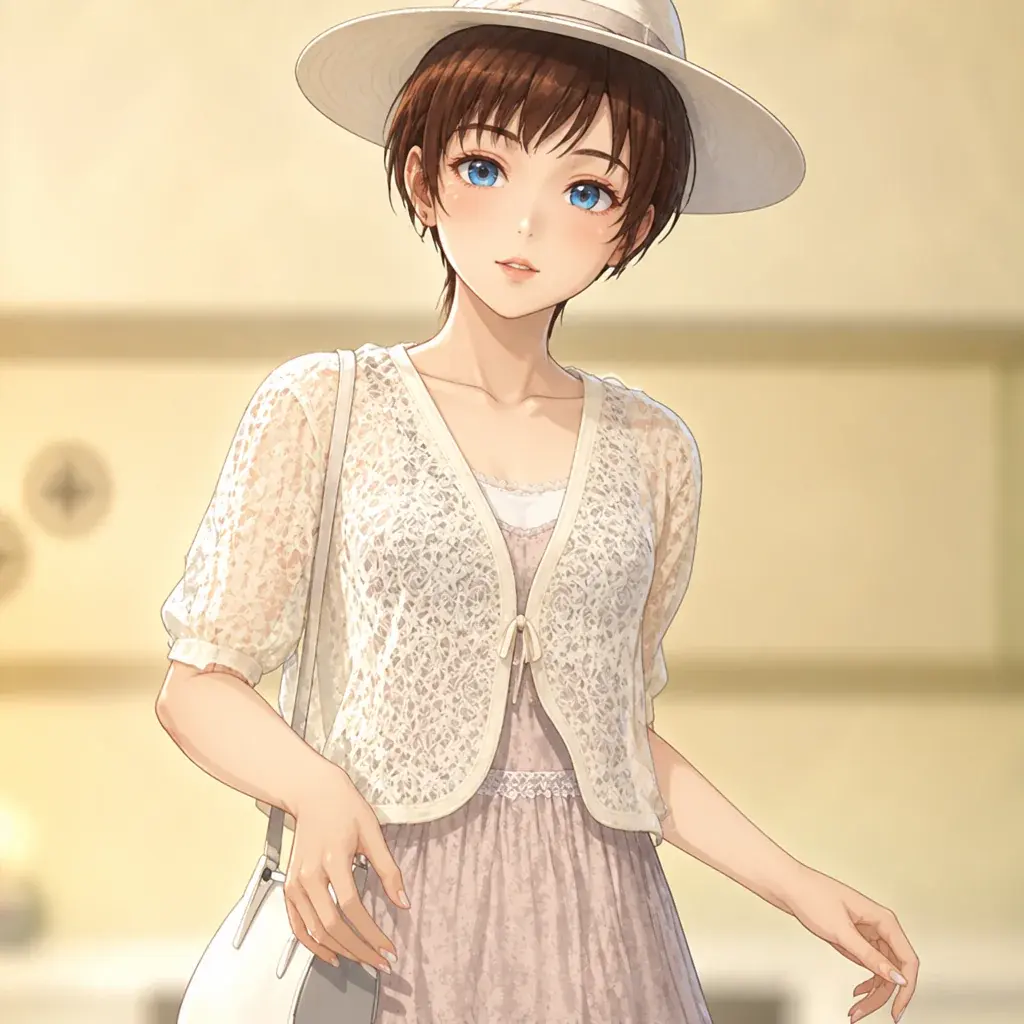
本站工作台实测 · 2026 年 9 月 29 日
我们使用下方完整指令,通过本站免费图生图模型生成右侧结果。可先对比帽子、头发、姿势和蕾丝开衫,再观察线条与布料细节的变化。
实测原文指令
Keep the woman's short brown hair, wide-brimmed hat, white lace cardigan, pose, framing, and warm background recognizable. Refine this image into a polished hand-painted anime illustration with clean linework, natural facial proportions, soft warm light, and detailed fabric texture. Do not add or remove objects.
这次结果保留了可识别的主体与取景,但重新诠释了面部和服装细节。使用前应根据自己的原图逐项检查。
这是一次成功生成的记录,不保证后续结果完全相同。
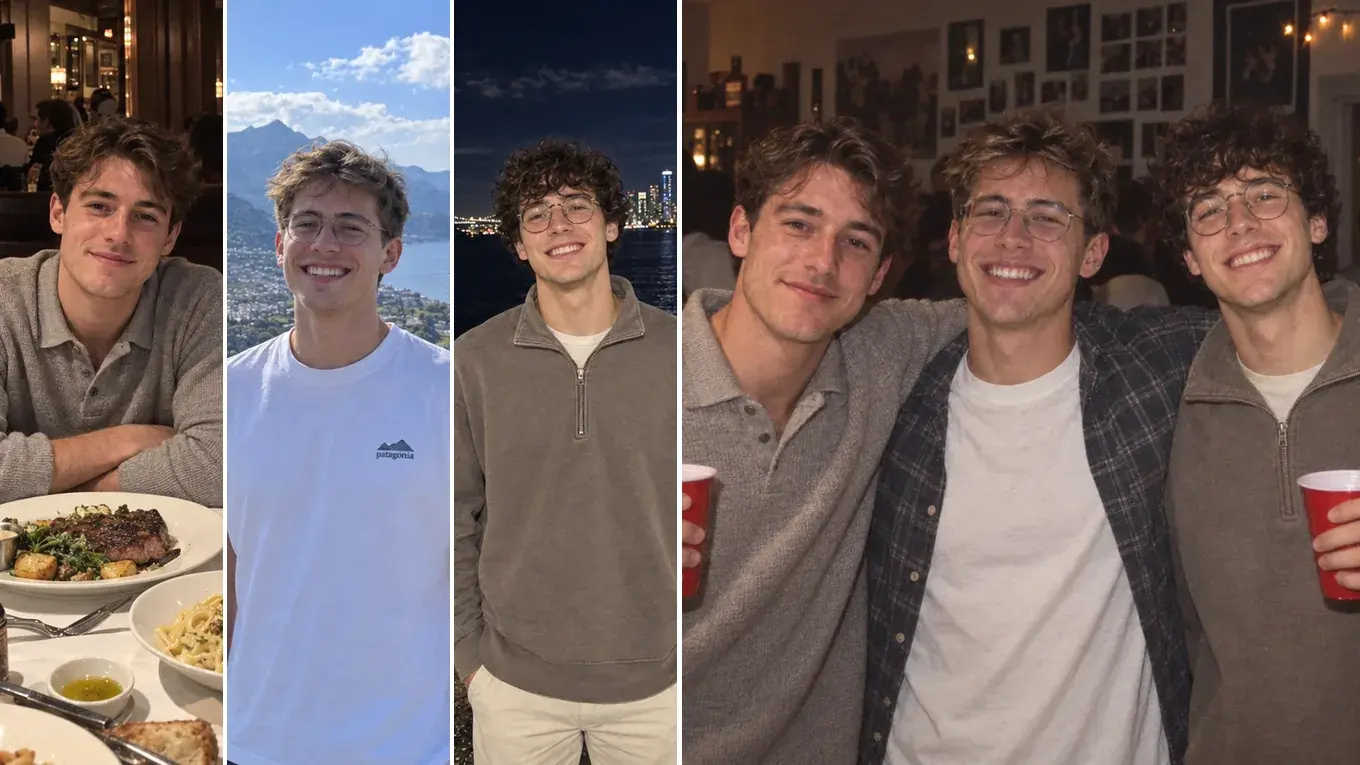
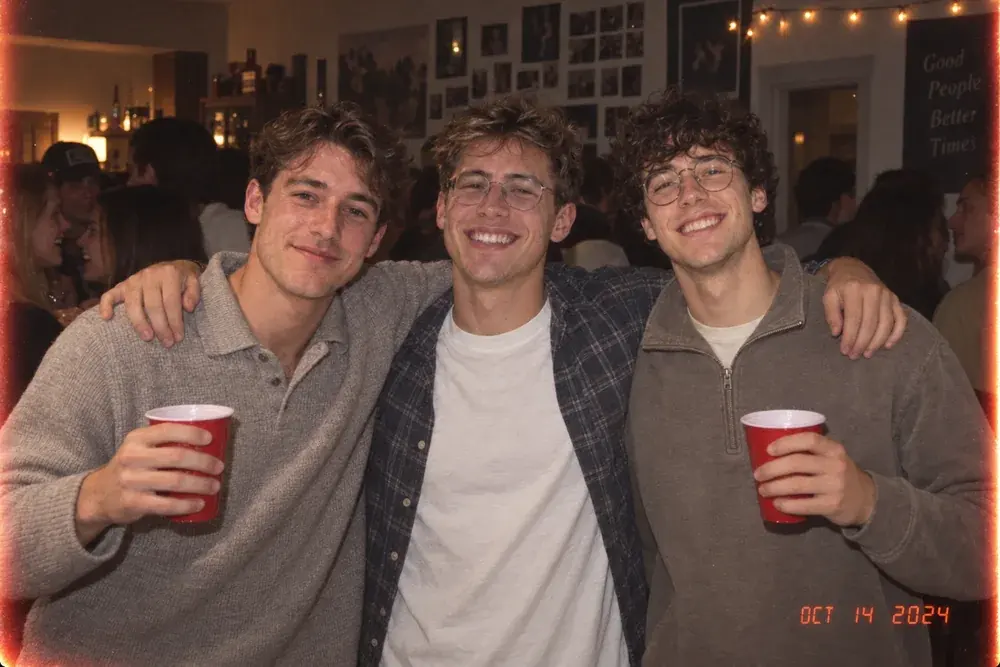
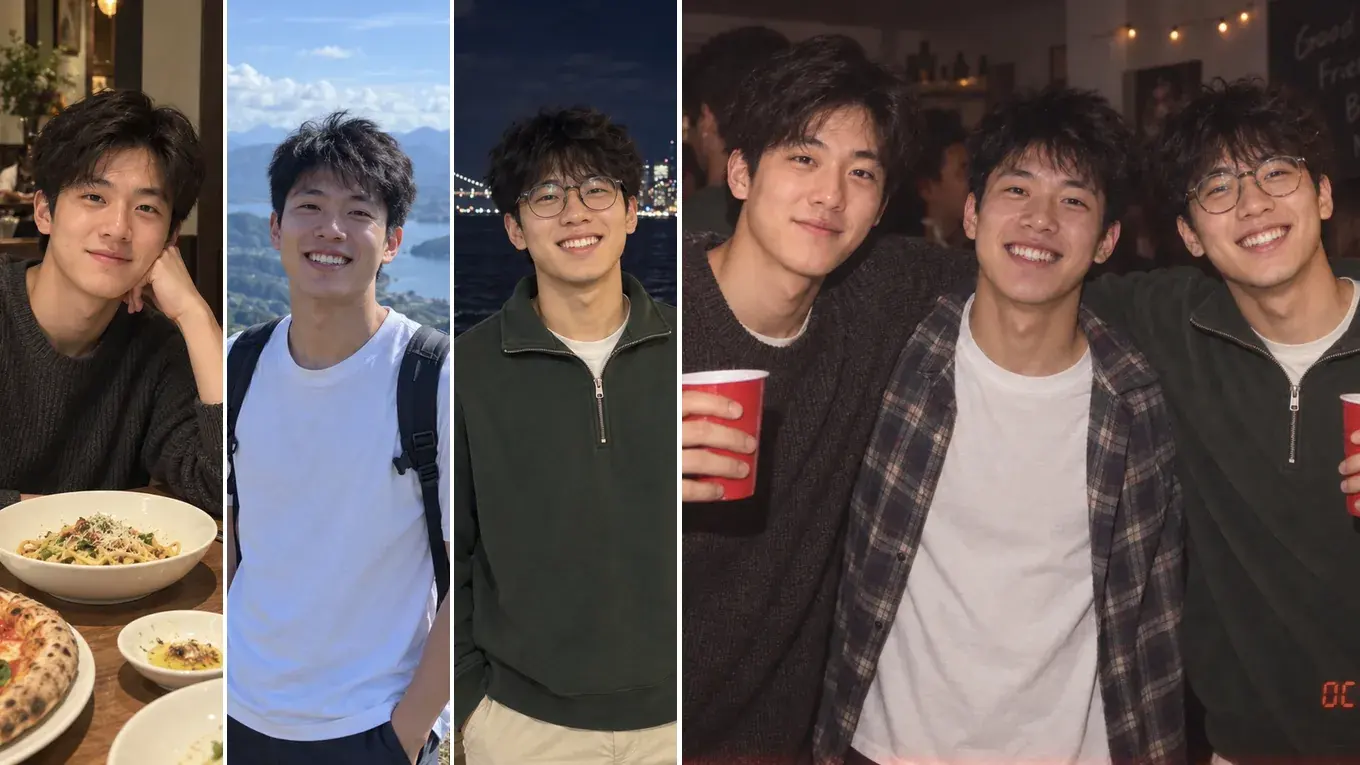
来自不同场景的三张单人照被融合进同一张聚会照片中,同时保持每位人物的面部特征与神态清晰可辨。
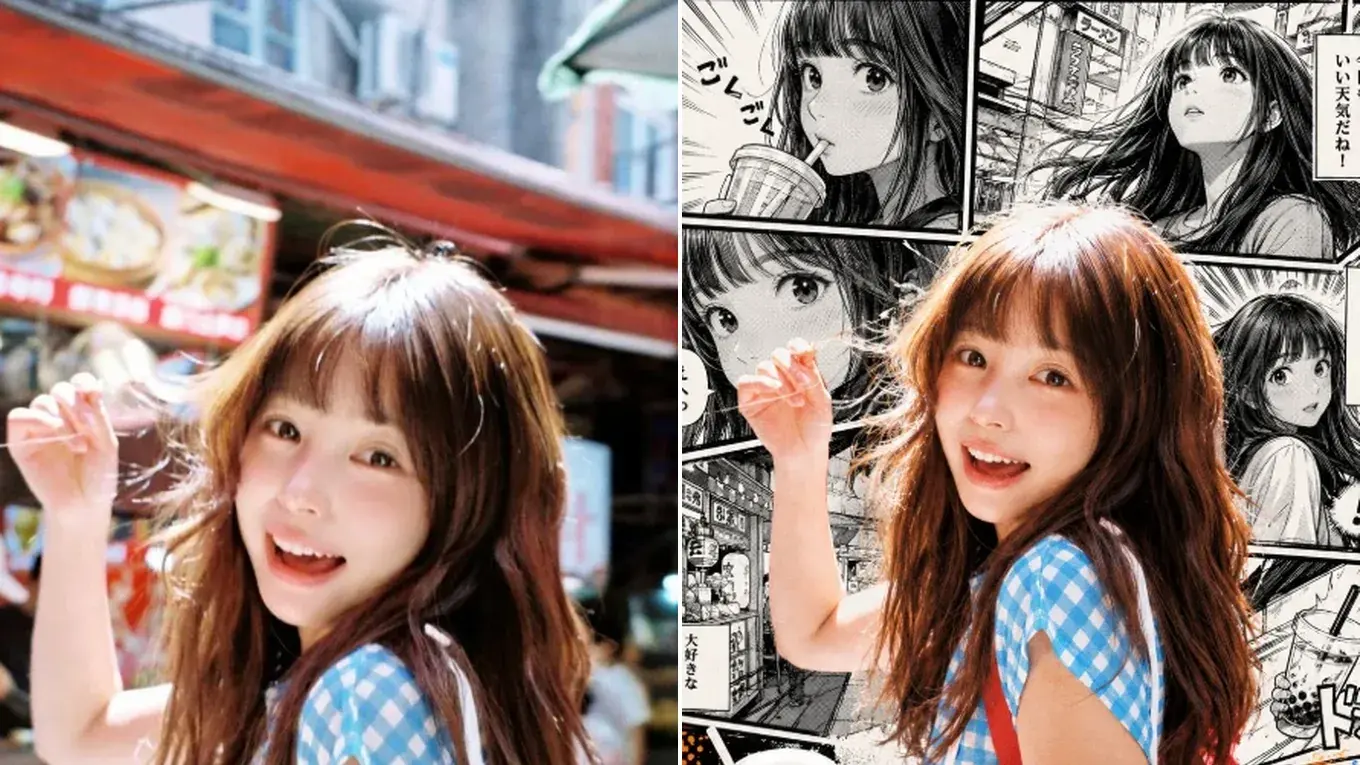
面部、姿势和取景保持便于对照,同时线条、色彩、纹理与背景语言进入新的视觉风格。
支持的 AI 图生图模型
在同一个图生图工作台中直观对比 Google DeepMind、OpenAI、阿里通义 Qwen、字节跳动 Seedream、Black Forest Labs Flux 与 xAI Grok 等主流图像模型。
对比全部 AI 模型
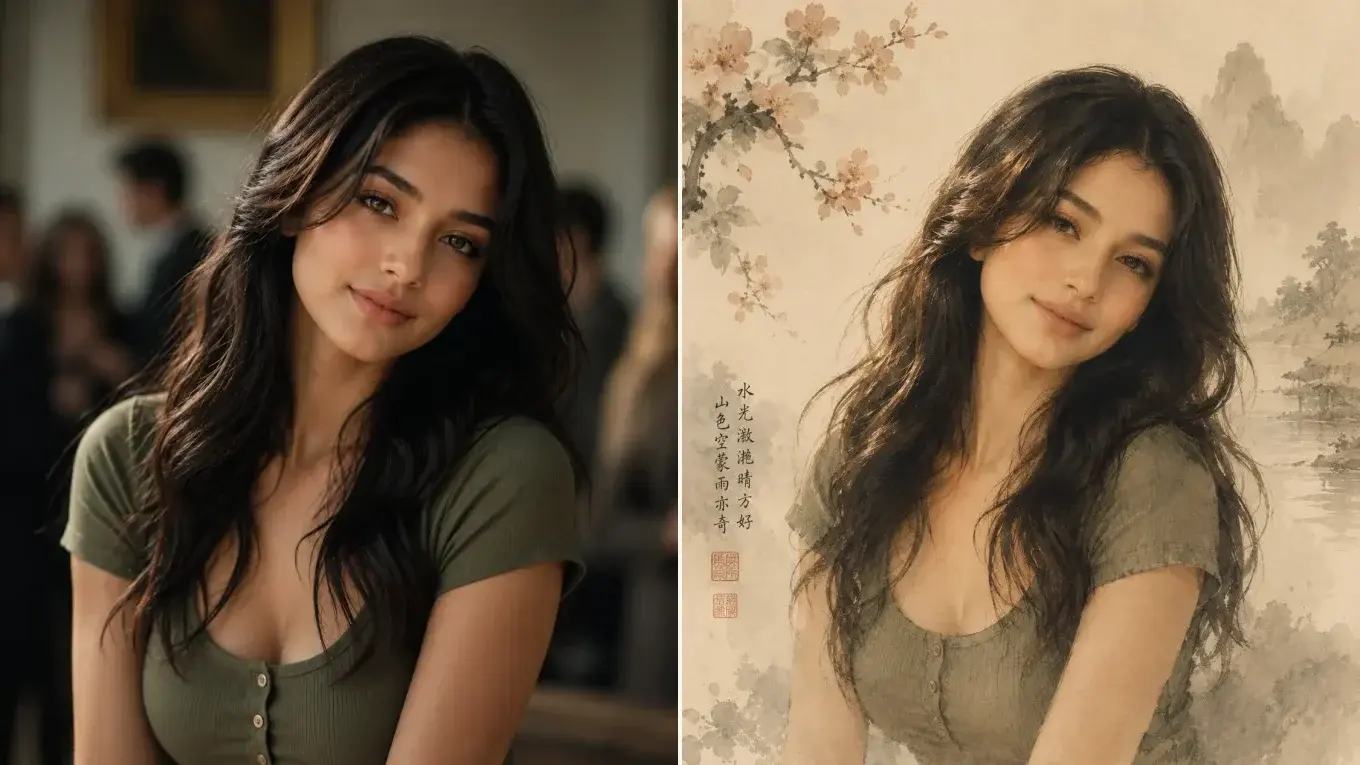
Img2Img 常见问题
选择原图、编写提示词和检查 Img2Img 结果时,用户真正需要的实用信息。
Img2Img 是 image-to-image generation(图生图 / 以图生图)的简称,也常被搜索为 photo to photo AI、pic to pic AI、upload image AI generator 或 AI image from image。现有图片提供视觉起点,提示词和模型设置引导生成新的结果。原图可以约束主体身份、姿势、形状、构图、色彩或其他视觉证据。
文生图只从文字开始;Img2Img 同时使用图片和指令,因此更适合风格转换、概念变体、草图完善、产品场景,以及需要保留部分视觉结构的编辑任务。
先说明哪些内容要保留,再描述具体变化,增加一个连贯的风格或处理方式,最后列出需要检查的细节。避免模糊要求和互相冲突的风格。聚焦的提示词更容易与原图比较,也更容易修正。
生成模型不能保证完全复制。清晰原图和准确锚点可以提高连续性,但仍应检查身份、人体结构、文字、Logo、比例和产品细节。需要像素级精确保留时,应使用确定性的图片编辑工具。
GPT Image 2(免费版)每天可免登录、免积分体验一次,之后可用积分继续生成。其他模型和更多设置需要 VIP 权益。
能否商用取决于你对原图拥有的权利、所选模型条款和最终内容。请使用你拥有或获准使用的图片,检查品牌资产和第三方权利,并在发布前确认适用的模型与产品条款。
从原图开始
上传一张清晰图片,写下一个聚焦的变化,再根据你选择保留的视觉锚点检查生成结果。